13 juil. 2016

[AI] Conférence sur le deep learning de Yann LeCun

Conférence de Yann LeCun sur le Deep Learning (apprentissage profond) à l'USI.

Introduction de la vidéo:
Jamais l'intelligence artificielle n'aura été aussi proche d'égaler l'intelligence naturelle qu'avec le deep learning. Notre compréhension actuelle de l'apprentissage machine, la disponibilité de données massives, d'ordinateurs parallèles rapides, et d'inspiration venant des neurosciences contribuent à l'explosion récente de cette nouvelle science qui depuis quelques années révolutionne l'état de l'art en reconnaissance de l'image et de la parole et en compréhension de la langue.Bien que les éléments techniques et scientifiques sous-jacents soient très complexes, la compréhension des principes fondamentaux du deep learning reste accessible à un public de non-initiés. Professeur à l’Université de New York, Yann LeCun est aujourd’hui reconnu comme étant le spécialiste mondial de l’intelligence artificielle et a tout récemment rejoint Facebook pour travailler sur le nouveau programme FAIR (Facebook Artificial Intelligence Research) dont un des bureaux se trouve à Paris. Cette session vous initiera à ce qui sera au cœur de l'intelligence artificielle de demain et de la R&D de Facebook.

1 juil. 2016

Comment créer votre startup de sécurité informatique

La sécurité des informations est devenue une fonction essentielle pour beaucoup d’organisations à l’âge digital et comme de plus en plus d’organisations externalisent leurs besoins en sécurité informatique, des opportunités pour les professionnels de la sécurité digitale de créer leur propre entreprise émergent.

Créer une entreprise
Créer une entreprise en sécurité informatique implique de s’astreindre à certaines régulations et lois. En France, cela signifie définir quel type de structure est préférable – une forme d’autoentrepreneur ou de société. Une société offre une sécurité accru des biens personnels, bien qu’un autoentrepreneur puisse protéger ses biens sous certaines conditions, telle qu’une déclaration de saisie, qui a pour but d’empêcher la saisie d’une maison pour payer une dette professionnelle. Un autoentrepreneur peut choisir de payer ses taxes comme des impôts sur le revenu ou bien comme l’impôt sur les sociétés s’il s’enregistre en tant que AERL (Autoentrepreneur à Responsabilité Limitée), une autre catégorie qui permet de séparer les biens professionnels et des biens personnels. Une société paiera soit l’impôt sur les sociétés ou bien sera taxée au régime du réel. Créer une société est plus complexe que de s’enregistrer en tant qu’autoentrepreneur puisque cela implique l’enregistrement d’un statut de compagnie auprès de la direction des finances publiques, la nomination de dirigeants, ainsi que la publication dans la presse légale. Les sociétés assujetties à la TVA doivent collecter la TVA sur les biens et les services qu’elles proposent et reverser ces fonds au gouvernement.

Qualifications
Un diplôme ou au moins un degré élevé de qualification sur les technologies de l’information fait partie du minimum requis pour toute personne désireuse de créer sa propre compagnie de sécurité informatique. Cependant, les habilitations professionnelles ne s’arrêtent pas à un diplôme. Quelqu’un qui cherche à créer sa compagnie en sécurité informatique ferait mieux d’avoir des certifications professionnelles telles que celles fournies par Microsoft ou Cisco. Les habilitations professionnelles apportent la tranquillité aux clients de la compagnie à laquelle ils confient leurs données de sécurité informatique et que cette dernière sait ce qu’elle fait et qu’elle dispose des qualifications et de l’expertise pour le prouver. La sécurité informatique repose sur la tranquillité, pourquoi dans ce cas une startup sur la sécurité informatique donnerait des raisons à ses clients de douter de son professionnalisme ? 
Toute personne souhaitant créer une startup en sécurité informatique doit s’assurer que les futurs employés embauchés au fur et à mesure que la compagnie se développe ont le même niveau de qualification.

Plans de développement
Les plans de développement sont essentiels à toute personne qui désire créer sa propre entreprise. On imagine souvent le plan de développement comme un document nécessaire à l’obtention de fond et d’investissement de la part d’une institution financière ou autre, mais un plan de développement est plus qu’un document qui permet la levée de fond. En réalité, avoir un plan de développement est très intéressant afin de définir des objectifs dès le début et de suivre les progrès à mesure que la compagnie se développe. Définir un plan de développement permet également à l’entrepreneur de reconsidérer certaines hypothèses, particulièrement si des tiers, plus objectifs, y ont accès et peuvent commenter ce document. Le gérant de l’entreprise peut également visualiser rapidement si deux objectifs ne sont pas en adéquation, comme par exemple les projections de vente et le budget marketing, ce qui lui permet de revoir ses buts.


Création d’un réseau
Dès lors que l’on lance une entreprise, il est primordial de créer un réseau et d’obtenir les noms des différentes compagnies. Créer un réseau est plus que le démarchage de clients potentiels. Cela signifie également créer des liens avec les professionnels de l’industrie visée et se tenir au courant de ce qui se passe dans ce domaine. La sécurité informatique, les professionnels le savent bien, est en constante évolution en matière de menaces possibles ; se tenir au courant de ces développements est donc indispensable à toute startup qui espère attirer des clients et les persuader qu’ils peuvent compter sur elle. Une startup dans la sécurité informatique à tout intérêt à rejoindre son groupe d’entreprises locales ainsi que toute autre association de professionnels du secteur.

Recherche
Se tenir informé au travers d’associations professionnelles est une chose, mais pour toute compagnie de sécurité informatique sérieuse, il est important de mener ses propres recherches sur les menaces actuelles. De nombreuses organisations n’ont tout simplement pas les ressources de se maintenir à niveau des menaces elles-mêmes et seront impressionnées par un fournisseur de service extérieur capable de discuter avec elles des dangers potentiels et de comment les suivre d’un point de vue sécuritaire.

Facturation
Être à la tête d’une entreprise florissante signifie avoir son propre système de facturation de clients et de collecte de l’argent. Pour de nombreuses startups, un système de facturation adapté est au-dessus de leurs moyens, sûrement à cause de ressources limitées mais peut-être aussi par manque de temps. Après tout, une entreprise débutante se doit de se centraliser sur la collecte et le maintien de clients, ce qui peut entraîner une faiblesse dans la partie administrative.

Il est possible de gérer la facturation de manière très efficace pour ces entreprises en utiliseun modèle de facturation créé spécialement pour que les petites entreprises facturent leurs clients. De la même manière qu’une startup de sécurité digitale est experte pour assister les clients dans la protection de leur système informatique, les professionnelles de la facturation ont l’expérience dont les petites entreprises ont besoin pour facturer leurs clients efficacement. Utiliser un modèle de facturation revient à accélérer la facturation et envoyer des modèles de factures qui impressionneront les clients qui verront qu’ils ont à faire à des gens sérieux. Les modèles de facturation peuvent être modifiés à chaque fois afin de prendre en compte tous les détails d’un système de comptes défini. Par exemple, certains clients pourraient demander une séparation détaillée de tous les services ou produits pour lesquelles ils payent.

L’aspect personnel
Démarrer une nouvelle entreprise est très chronophage et pour ceux impliqués dans la startup, ils découvriront qu’ils ne disposent que de peu de temps pour leur vie privée, au moins durant les premières années. Chaque entrepreneur en herbe se doit de parler à sa famille et ses proches pour leurs expliquer qu’il ne pourra peut-être pas passer autant de temps avec eux qu’il le souhaite. S’il peut se dégager un peu de temps libre, il serait sage pour le propriétaire de la nouvelle startup de le passer avec ses proches, ou de faire quelque chose d’agréable plutôt que de se concentrer seulement sur le travail.

Une entreprise de sécurité informatique doit être capable de convaincre les clients qu’elle est une compagnie sérieuse qui prend l’approche la plus professionnelle possible. Avoir des systèmes en place efficaces à toutes les étapes de la relation avec les clients, du marketing aux ventes en passant par l’intégrité du service lui-même et de la facturation des clients est essentiel.


30 juin 2016

[ANSIBLE] Multistage environments with Ansible

Article intéressant concernant la gestion de multiples environnements dans Ansible, et notamment des variables.


Ansible has excellent documentation but one thing I was confused about was the best way to store the configuration for multistage projects: say, different passwords for dev, staging, production. This isn’t really covered in the ansible-examples repo because it’s specific to your project and while the documentation has recommendations, it doesn’t spell it out completely (which I need since I’m an idiot).

In the old days, the easiest place to keep the configuration was in your inventory file. Since these store the server IPs you run your playbooks against, they’re inherently stage-specific. However, storing everything in the inventory can be limiting and is officially discouraged.

Instead, the best practices guide suggests a different structure, one that’s based on keeping your config in the group_vars and host_vars directories. At first glance, the linked example confused me because it seemed to be mixing a lot things together in one file: IP addresses, role assignments, location, datacenter, etc and then mixing these together. However, after some trial & error, talking to some smart folks and a lot of googling, I’ve hit on a structure that’s worked well for my last couple of projects so I’d like to write about it here.

So, let’s take the example above and pare it down to something simpler:

We’ll create an inventories directory and place a “production_servers” inventory file in there.
; inventories/production_servers
[web]
4.2.2.1
4.2.2.2
[database]
8.8.8.8
This file does one thing and does it well, it sorts our server IPs into different groups. Now, “Group” is the magic word here. Whenever we run a playbook with this inventory, Ansible isn’t just loading the inventory. It’s also looking at the group names we set (the header sections of the INI) and then trying to match those to a file with the same name in the group_vars directory. This isn’t explicitly configured, it’s just something Ansible does by default.

So, since we mentioned a “web” group and a “database” group, Ansible will try to load the files “group_vars/web” and “group_vars/database”. These are expected to be YAML key/values lists and we can use them to define all Ansible variables that you likely have sprinkled throughout your roles. For example, the database vars file might look like this:
# group_vars/database
---
db_port: 3306
db_user: app_user
db_password: SuperSecureSecretPassword1
# group_vars/web

---
domain_name: myapp.com
csrf_secret: foobarbaz
Here we’ve defined a few variables you’d use in a role like {{ db_password }} or {{ domain_name }}.

So far, so good. By now, our ansible directory probably looks something like the example below. Keep in mind the group_var file names are based entirely on the header names inside the inventory file, NOT the naming of the inventory file themselves.

    .
    ├── group_vars
    │   ├── database
    │   └── web
    │
    ├── inventories
    │   └── production_servers
    │
    ├── roles
    │   └── ...
    │
    └── my_playbook.yml

Now comes the multistage part. We don’t want to use the same db_password for dev, staging and production, that’d be terrible security. And we probably want to change the domain name. And the SSL certificates. And all sorts of other things, which we’d prefer to maintain in just one place. How can we group the configuration together per stage?


Remember, Ansible will try to load a group_vars file for any group it encounters in your inventory. All it takes to define a group is adding a section for it in the inventory’s INI file. So, why don’t we create a “production” group?
; inventories/production_servers
[web]
4.2.2.1
4.2.2.2
[database]
8.8.8.8
[production]
4.2.2.1
4.2.2.2
8.8.8.8
We’ve now created a production group and assigned all the production servers to live underneath it so they all get the exact same configuration. I haven’t tested it completely but this is really important if your configuration overlaps between roles, such as using the db_password on the web servers.

However, duplicating all of the IP addresses is a real pain and it would super easy to add another web server and forget to update the list at the bottom of the file. Luckily, Ansible has an inheritance syntax to make this easier.
; inventories/production_servers
[web]
4.2.2.1
4.2.2.2
[database]
8.8.8.8
[production:children]
web
database
This example does the exact same thing as the previous version: it creates a group called “production” but now it’s defined as a group of groups. Any IP address added to the “web” or “database” groups is automatically part of the “production” group (at least, when running a playbook with this inventory).

That means we can now create a group_vars/production file where we can group the parts that are specific to this stage:
# group_vars/production
---
domain_name: myapp.com
db_password: SuperSecureSecretPassword1
csrf_secret: foobarbaz
These are the things we’re interested in changing per stage. Other stuff that’s the same 99% of the time like port numbers or standard users, we can leave in group_vars/database.

Now, if we wanted to add a staging setup, we only need to add two files: a new inventory…
; inventories/staging_servers
[web]
8.8.4.4
[database]
4.2.2.3
[staging:children]
web
database
and a group_var/staging config.
# group_vars/staging
---
domain_name: staging.myapp.com
db_password: LessSecretButStillSecurePassword
csrf_secret: St4gingCSRFToken
Notice that the basic format is the same, and we can use this to add any number of stages we like:

    .
    ├── group_vars
    │   ├── all
    │   ├── database
    │   ├── dev
    │   ├── production
    │   ├── staging
    │   └── web
    │
    ├── inventories
    │   ├── dev_servers
    │   ├── production_servers
    │   └── staging_servers
    │
    ├── roles
    │   └── ...
    │
    └── my_playbook.yml

In the above example, we’ve now added a dev stage which probably lists our Vagrant IP as both the web server and db server. You might also notice a group_vars/all file. This is a special file that Ansible loads in every time, no matter what groups you use, making it an excellent place to stash your default config.

So, using this setup we have a working and reasonably well centralized multistage setup in Ansible. We’ve also got the config split out nicely so we can use ansible-vault to encrypt our staging and production settings. This works really well and I’ve used it successfully in a couple projects now.

However, there are a couple gotchas to notice. The big one is inheritance order. If you define a config value in multiple groups (say, “db_port” in both “database” and “all”), then Ansible follows particular rules to determine which one wins. For this setup, the priority from highest to lowest is:

type (web, database)
stage (dev, staging)
the “all” file
This is kind of bad, because we probably want the stage files to take precedence but the type files are overriding. It turns out, this is because we used the “:children” style to define the stage in our inventory. This marks the “web” and “database” servers as children of the “production” group and as the Ansible documentation says “Child groups override parent groups”. We could try to work around it by making more specific groups and controlling the hierarchy more tightly:
[production-web]
4.2.2.1
4.2.2.2
[production-database]
8.8.8.8
[production:children]
web
database
[web:children]
production-web
[database:children]
production-database
But this hasn’t worked in testing for me because when the groups are equal, Ansible does precedence alphabetically so “web” is still overriding “production”. Also, while more specific, this is quite a bit more boilerplate for each ansible file.

In practice, I haven’t used the type specific group_vars files much, instead relying on role defaults or the “all” file. The end result has been much simpler and I don’t have to worry as much about where something is defined.

This brings us to the second gotcha: This is reasonably simple on the small scale but it can be more complex. Super nice guy Ramon de la Fuente told me he’s been running this setup (or one very similar) for a while and has found it a bit awkward to manage as it grows. I haven’t tried it on a very large installation yet but I’m inclined to believe him. You should check out his latest Ansible article for more tips.

Still, for a small to mid-size project, this is a straightforward, practical setup. If you do need very fine-grained control and you’re not running several servers per stage, consider looking into the host_vars directory which is the same thing as group_vars but per server instead of per group. And finally, remember, Ansible’s group system is essentially a free-form tagging system: it’s a simple, powerful way to build any setup you want.

Like, you know, Ansible itself.

Update: Erika Heidi wrote a great add-on post to this that talks about integrating this setup with Vagrant and how to configure your remote servers

The setup presented here is essentially that from the (excellent) Ansible Docs and Mailing List, I’m just explaining it a bit more. Many thanks to Ramon de la Fuente and Rafael Dohms for Ansible feedback, as well as Erika Heidi and Rick Kuipers for proofreading this article.

22 juin 2016

[SECU] si même Zuckerberg ...


Si même Mark Zuckerberg prends ce genre de précautions. Nos VIP devraient peut être en faire de même (chefs d'entreprise, industriels, hommes politiques, etc.)

Source : http://gizmodo.com/wow-mark-zuckerberg-is-paranoid-as-fuck-1782370124

[SECU] Qu'est-ce q'un Ransomware ?

Aussi connu sous le nom de "logiciel de rançonnage" ou "rançongiciel"! Cette infographie de Trend Micro explique bien à quoi correspond ce risque en sécurité et comment l'éviter:


Source: http://www.cnetfrance.fr/news/infographie-le-ransomware-explique-en-image-39838662.htm


Aller plus loin :

15 juin 2016

[ASTUCE] Ses todolist, notes et planning sur une feuille A4

L'article suivant est extrait du blog de David Manise, instructeur de survie, et patron du CEETS (Centre d’Etude et d’Enseignement des Techniques de Survie).
J'ai trouvé intéressante l'astuce qu'il a partagé consistant à faire tenir son planning, ses RDV, ses notes etc. sur une feuille A4. 

Quand on a pas mal de chose à faire ça peut être pratique. Surtout si notre smartphone tombe en panne de batterie. Bref du low-tech,
simple et concis. Bonne lecture.


Source : http://blog.davidmanise.com/todo-list-of-death/
Todo list of death
Bon…  survie ordinaire, mais survie quand-même.
Un ami m’a demandé comment je m’en sortais pour organiser l’énorme masse de boulot, de RV, de déplacements que j’ai.  Et quand je lui ai dit que tout le merdier tenait en général sur une seule feuille A4, il m’a ri au nez.  Et je lui ai montré, et il a compris…  le tout, c’est de comprimer les données grâce à des méta-données symboliques, qui permettent de réduire le blabla.
Donc, en clair, j’ai un bête fichier texte (police à chasse fixe) sur mon ordinateur, que j’édite et que j’imprime au besoin.  Ca me permet d’avoir le truc papier sur moi et de pouvoir ajouter / rayer des tâches sans devoir allumer mon ordinateur pour gérer le planning.  J’ai aussi mon agenda complet de l’année en permanence dans la poche, au moins dans les grandes lignes.  Et je mélange les tâches, les RV, les déplacements, et tout dans le même « log », avec les trucs à faire à peu près dans l’ordre.  Tous les trucs récurrents sont dans ma tête…
Et il y a un petit code tout simple qui permet de s’y retouver facilement.  Je vous montre le truc, vous allez piger tout de suite.  Je vous copie/colle l’exemple.
TODO LIST - 
.tâche  °RV  * important  //départ  \\retour  -projet à suivre

  . truc à faire
  ° 15 juin 1445 : rv trop sympa
* ° 16 juin 1700 : rv important !
  // 19 juin 1900 : aéroport machin, terminal X, #VOL, pays
   . voir untel
   ° 22 juin 1200 LOCAL : RV ambassade
   ° 23 juin 1400 LOCAL : dèj blabla
  \\ 24 juin 1700 LOCAL : aéroport mbidule, #VOL, retour pays
* . REPOS / JET LAG
  - Projet coopération : documentation 4h
  . acheter billets blabla / confirmer @ Matins du monde
  ° RV avec [surnom ou nom codé si jamais je perds la feuille...]
Bref, vous voyez le topo.
J’imprime le tout, je crayonne dessus, et de temps en temps je reporte les gribouillis, efface les trucs faits, etc. dans le fichier informatique, et j’imprime à nouveau.
Voilà, c’est gratuit ;)
David

8 juin 2016

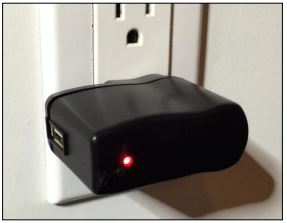
[SECU] Des enregistreurs de frappes camouflés en chargeurs USB

Le FBI alerte ses partenaires de l'industrie privée 15 mois après le début de KeySweeper

Le FBI a publié un PDF qui décrit comment des chargeurs USB génériques peuvent être utilisés pour espionner les frappes de clavier. « S’ils sont placés stratégiquement dans un bureau ou un autre endroit où les individus peuvent utiliser des appareils sans fil, une personne malveillante pourrait potentiellement récolter des informations personnelles, la propriété intellectuelle, des secrets commerciaux, des mots de passe ou d'autres informations sensibles. Comme les données sont interceptées avant d'atteindre le CPU, les responsables de sécurité ne peuvent pas se rendre compte de cette interception de données sensibles », écrit le FBI.

Cette notification est venue 15 mois après que le hacker white-hat Samy Kamkar a mis au point son keyloggeur capable d’intercepter toutes les frappes sur un clavier Microsoft sans fil. Un keyloggeur est un logiciel capable d'enregistrer et capter toutes les frappes sur un clavier sans fil. Le keyloggeur en question ici a été baptisé KeySweeper qu'on peut traduire par « chercheur de touches ».

L’appareil composé d’un Arduino placé dans un chargeur USB pour camoufler son usage, peut être branché. Pendant ce temps, il enregistre chaque touche appuyée sur le clavier dans sa mémoire ou carrément envoie ces données en ligne à l’aide d’une puce GSM, une interface web permet alors de les capter.

Chargeur USB camouflant le KeySweeper


Le KeySweeper démonté. On peut voir la carte Arduino, un moniteur RF et une carte SIM

On se demande pourquoi le FBI a attendu 15 mois avant de prévenir ses partenaires de l'industrie privée à propos de cette menace. Quant à Microsoft, des responsables ont précisé que cette attaque ne concerne que les appareils sans fil qui n’utilisent pas une cryptographie forte pour chiffrer les données transmises entre le clavier et l’ordinateur. La firme a affirmé que ses claviers manufacturés après 2011 utilisent un chiffrement standard avancé, et de ce fait, ils sont protégés contre toute attaque de sniffing.


Différences majeures entre Red Hat 6, 7, 8 et 9

Quelles sont les différences majeures entre RHEL 6, 7, 8 et 9 ? Système de fichiers RHEL 6: Par défaut : ext4. Autres : ext2, ext3 supportés...